


Monolit IT Sp. z o.o.
ul. Warsztatowa 12, 81-341 Gdynia
tel. +48 58 763 30 00
tel. +48 58 763 30 10
e-mail: biuro@monolit-it.pl
28.09.2026
Udostępnij

Projektowanie infrastruktury AI wymaga więcej niż wydajnych GPU. Sprawdź, jak pamięć, storage, sieć, zasilanie i chłodzenie wpływają na wydajność serwerowni oraz skalowanie środowisk AI.
W klasycznym projekcie infrastruktury rozmowa często zaczyna się od liczby maszyn, pojemności macierzy i oczekiwanego wzrostu danych. Przy AI ten porządek szybko przestaje działać. Pierwsze pytanie powinno brzmieć inaczej: co dokładnie ma policzyć środowisko i jak szybko dane mają dotrzeć do akceleratorów?
To nie jest różnica semantyczna. Kosztowny GPU może przez znaczną część zadania czekać na dane, komunikację z innymi akceleratorami albo zapis punktu kontrolnego. Na fakturze widać wtedy moc obliczeniową, a w wyniku biznesowym - opóźnienie.
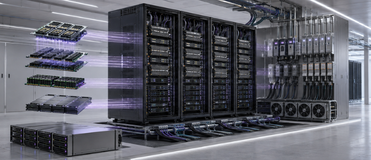
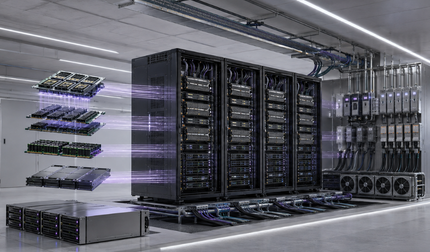
Notatka architektoniczna: serwerownia dla AI nie jest zbiorem szybkich elementów. Jest jednym torem danych, w którym wydajność wyznacza najsłabiej dopasowana warstwa.
Grafika 1. Wydajność AI zależy od równowagi całego toru danych, a nie jednego komponentu.
Dwa projekty opisane jako „platforma AI” mogą mieć skrajnie inne potrzeby. Trening dużego modelu pracuje seriami, intensywnie korzysta z komunikacji między akceleratorami i zapisuje duże checkpointy. System wizyjny na produkcji oczekuje krótkiej, przewidywalnej odpowiedzi. Asystent oparty na modelu językowym musi utrzymać jednoczesne sesje i zmienną długość kontekstu.
Dlatego specyfikację warto rozpocząć od profilu zadania: wielkości zbioru, rozmiaru modelu, częstotliwości aktualizacji, tolerowanego opóźnienia, liczby użytkowników, wymaganej dostępności i miejsca przetwarzania danych. Dopiero z tych założeń wynika sensowna architektura.
GPU (Graphics Processing Unit) to procesor wyspecjalizowany w masowo równoległych obliczeniach. Wysoki poziom jego wykorzystania nie przesądza jednak, że platforma realizuje zadanie optymalnie. Urządzenie może wykonywać operacje pomocnicze, czekać na synchronizację albo przetwarzać zbyt małe partie danych.
Lepsze pytania brzmią: ile użytecznej pracy wykonano w jednostce czasu, ile trwało zadanie od kolejki do wyniku i jaki był koszt wyniku. Dla inferencji mogą to być czas odpowiedzi i przepustowość, a dla treningu - czas do osiągnięcia oczekiwanego rezultatu oraz stabilność kolejnych przebiegów.
Arkusz z parametrami modelu jest potrzebny, ale nie pokaże chwilowych skoków I/O, nierównego rozkładu danych, opóźnień potoku przygotowania próbek czy sposobu, w jaki aplikacja zapisuje checkpointy. Próba na reprezentatywnym fragmencie danych zwykle mówi o projekcie więcej niż porównanie samych kart katalogowych.
Najbliżej obliczeń znajduje się pamięć akceleratora. VRAM to pamięć dostępna bezpośrednio dla GPU; w wielu systemach wykorzystuje się pamięć typu HBM (High Bandwidth Memory), projektowaną pod bardzo wysoką przepustowość. Mieszczą się w niej m.in. parametry modelu, aktywacje i bufory operacji.
Jeśli zadanie nie mieści się w pamięci GPU, trzeba je dzielić między urządzenia, ograniczać wielkość partii, stosować inne formaty danych albo przenosić fragmenty do pamięci hosta. Każda z tych decyzji wpływa na komunikację i czas wykonania.
DRAM - pamięć operacyjna serwera - obsługuje system, przygotowanie danych, bufory transferu i procesy wejścia-wyjścia. Za mała pojemność może wymuszać nadmierne odwołania do storage, a niewłaściwa topologia procesorów, pamięci i magistrali PCIe potrafi ograniczyć transfer mimo poprawnej sumy parametrów.
W storage pozostają surowe zbiory, wersje danych, artefakty eksperymentów, modele, logi oraz punkty kontrolne. Nie wszystko musi być przechowywane na najdroższej warstwie, ale dane potrzebne w bieżącym zadaniu muszą być podane w rytmie, którego wymaga klaster.
 Grafika 2. Każda warstwa pamięci ma inną rolę, pojemność i koszt dostępu.
Obciążenie AI potrafi jednocześnie wykonywać wiele małych odczytów, czytać duże sekwencje, losowo sięgać do plików i okresowo zapisywać duże checkpointy. Średnia przepustowość nie opisuje więc całej sytuacji. Liczą się też opóźnienia, równoległość, metadane, zachowanie przy obciążeniu mieszanym i szybkość powrotu po błędzie.
Praktyczny model rozdziela dane według temperatury i sposobu użycia:
Warstwy muszą mieć jasno opisane zasady promocji, usuwania i archiwizacji. W przeciwnym razie szybka przestrzeń z czasem staje się kosztownym magazynem wszystkiego.
Checkpoint umożliwia wznowienie długiego zadania bez rozpoczynania od zera. Jego harmonogram powinien uwzględniać koszt ponownego obliczenia, czas zapisu, wpływ na trening i docelowe miejsce ochrony. Zbyt częste zapisy mogą hamować klaster; zbyt rzadkie zwiększają stratę po awarii.
Gdy zadanie korzysta z wielu GPU lub węzłów, dane i wyniki pośrednie muszą być wymieniane z małym opóźnieniem. Interkonekt to warstwa komunikacyjna łącząca akceleratory i serwery. Nie należy utożsamiać jej ze zwykłą siecią dostępową dla użytkowników i systemów zarządzania.
Sieć front-end obsługuje dostęp do usług, administrację i integracje. Sieć obliczeniowa przenosi synchronizację między akceleratorami, ruch rozproszonych zadań oraz dostęp do równoległego storage. Mieszanie tych funkcji bez analizy może prowadzić do zakłóceń trudnych do zdiagnozowania.
 Grafika 3. GPU nie powinny czekać ani na dane, ani na komunikację z innymi akceleratorami.
Dodanie kolejnych GPU zwiększa również koszt komunikacji, synchronizacji, zasilania i chłodzenia. Jeżeli aplikacja nie potrafi skutecznie rozdzielić zadania albo interkonekt nie nadąża, osiem urządzeń nie wykona pracy osiem razy szybciej. Pilotaż powinien więc sprawdzić efektywność skalowania, a nie tylko działanie pojedynczego węzła.
Gęste węzły GPU zmieniają rozkład mocy w szafie, zapotrzebowanie na zasilanie awaryjne i sposób odprowadzania ciepła. Średnie zużycie nie wystarcza do projektu. Trzeba uwzględnić wartości szczytowe, nierównomierność obciążenia, redundancję, pracę podczas awarii oraz możliwość późniejszej rozbudowy.
Przy niższej gęstości poprawnie zaprojektowane chłodzenie powietrzem może być właściwe. Przy wyższych mocach na szafę rośnie znaczenie chłodzenia cieczą — bezpośrednio do komponentów lub przez wymienniki przy szafach. Decyzja dotyczy jednak całego obiektu: hydrauliki, monitoringu wycieków, procedur serwisowych, części zamiennych i kompetencji zespołu.
Sygnał projektowy: jeżeli analiza GPU i analiza zasilania powstają w osobnych strumieniach i spotykają się dopiero przy wdrożeniu, projekt jest już obciążony ryzykiem.
W projektach infrastruktury AI Monolit IT analizuje nie tylko platformę serwerową, lecz cały tor danych — od GPU i pamięci, przez storage i sieć, po wymagania zasilania i chłodzenia.
Trening zwykle wymaga wysokiej przepustowości, wydajnej komunikacji między GPU, szybkiego dostępu do dużych zbiorów oraz sprawnego zapisu checkpointów. Prace są długie, więc znaczenie mają odporność na błędy i możliwość wznowienia.
Inferencja to wykorzystanie wytrenowanego modelu do generowania wyniku. Tu częściej liczą się czas odpowiedzi, liczba równoległych żądań, stabilność usługi i przewidywalny koszt. Architektura może korzystać z mniejszych instancji, partycjonowania zasobów lub innych akceleratorów niż środowisko treningowe.
Przetwarzanie przy źródle danych ogranicza opóźnienie i transfer, ale wprowadza wymagania dotyczące pracy w ograniczonej mocy, zdalnego utrzymania, aktualizacji modeli oraz działania przy utracie łączności. Centralna serwerownia nadal może przygotowywać modele i zarządzać ich cyklem życia.
Grafika 4. Trening, inferencja i edge AI wymagają różnych priorytetów architektonicznych.
Kosztowne zasoby tracą wartość, gdy zadania czekają w źle zarządzanej kolejce albo zajmują całe urządzenie mimo niewielkiego zapotrzebowania. Orkiestracja powinna uwzględniać priorytety, rezerwacje, izolację zespołów, limity oraz sposób współdzielenia akceleratorów.
Monitoring musi połączyć trzy perspektywy: infrastrukturę, wykonanie modelu i warunki obiektu. Sama temperatura GPU nie wyjaśni problemu, jeśli przyczyną jest storage; sam wykres I/O nie pokaże, że zadanie wykonuje niewłaściwy kod.
Przykład modelowy, nie opis klienta. Firma planuje analizować obrazy z kilku linii i rozpocząć od centralnego klastra GPU. W pierwszym teście model osiąga oczekiwaną dokładność, lecz opóźnienie rośnie przy równoczesnym napływie obrazów. Analiza ujawnia, że problemem nie jest moc GPU, ale przygotowanie plików i przeciążona wspólna ścieżka storage.
Zespół wydziela szybki bufor dla aktywnych danych, porządkuje potok dekodowania, rozdziela ruch użytkowy od obliczeniowego i ustala limit czasu odpowiedzi. Dla linii wymagających natychmiastowej decyzji część inferencji trafia na węzły edge, a centralne środowisko pozostaje miejscem treningu i zarządzania modelami.
Wniosek nie brzmi „kupiono szybszą macierz”. Rozwiązano konkretny przepływ pracy, a dopiero potem dobrano warstwy infrastruktury.
TCO (Total Cost of Ownership) oznacza całkowity koszt posiadania. W tym przypadku obejmuje sprzęt, sieć, storage, licencje, energię, chłodzenie, przestrzeń, utrzymanie i kompetencje. Powinien również uwzględniać koszt czasu w kolejce, niewykorzystanej mocy oraz przerywanych zadań.
 Grafika 5. KPI powinny mierzyć dostarczoną pracę i koszt wyniku, nie tylko wykorzystanie GPU.
Do stałego pomiaru warto włączyć:
Nie ma jednego poprawnego zestawu dla „firmowej AI”. Jest za to powtarzalna kolejność pytań:
 Grafika 6. Dobór GPU powinien być skutkiem analizy przypadku użycia i całego środowiska.
Na tym etapie wartościowy audyt nie powinien kończyć się listą urządzeń. Powinien wskazać zależności, ryzyka, warianty architektury oraz dane, których jeszcze brakuje do bezpiecznej decyzji. To właśnie w takim zakresie wsparcie zespołu Monolit IT pozwala przejść od pomysłu na AI do projektu, który można obronić technicznie i finansowo.
AI zmienia projektowanie serwerowni, ponieważ łączy obliczenia, pamięć, storage, sieć i warunki obiektowe w jeden intensywnie pracujący system. Najdroższy GPU nie usunie wąskiego gardła utworzonego kilka warstw wcześniej.
Najbezpieczniejsza kolejność jest prosta: najpierw przypadek użycia i pomiary, następnie architektura całego toru danych, później pilotaż, a dopiero na końcu skala. Dzięki temu organizacja kupuje zdolność do realizacji zadania — nie tylko imponującą specyfikację.