


Monolit IT Sp. z o.o.
ul. Warsztatowa 12, 81-341 Gdynia
tel. +48 58 763 30 00
tel. +48 58 763 30 10
e-mail: biuro@monolit-it.pl
19.10.2026
Udostępnij

Testy odtworzeniowe pokazują, czy backup naprawdę pozwala odzyskać system po awarii lub ransomware. Sprawdź RTO, RPO, scenariusze testów i najczęstsze błędy.
Liczba kopii zapasowych jest łatwa do policzenia i dobrze wygląda w raporcie. Nie odpowiada jednak na najważniejsze pytanie: czy po awarii, ransomware albo błędzie administracyjnym organizacja potrafi odzyskać działającą usługę w czasie akceptowalnym dla biznesu?
Kopia może istnieć, przejść zadanie backupowe bez błędu i nadal okazać się nieprzydatna. Może być niekompletna, niespójna z innymi komponentami, zaszyfrowana niewłaściwym kluczem albo niemożliwa do uruchomienia w zmienionym środowisku.
Najważniejszy wniosek: wykonany backup jest dowodem zapisania kopii. Udany test odtworzeniowy jest dowodem, że organizacja potrafi tę kopię wykorzystać. Dopiero pełne ćwiczenie pokazuje, czy potrafi przywrócić proces biznesowy, a nie tylko pojedynczy plik lub maszynę.
 Wartość kopii potwierdza dopiero możliwość odbudowy działającej usługi.
Test odtworzeniowy backupu to kontrolowana próba przywrócenia danych, aplikacji lub całego środowiska IT z kopii zapasowej. Jego celem jest sprawdzenie, czy dane są kompletne i spójne, system można uruchomić, a usługę przywrócić w czasie zgodnym z wymaganiami biznesowymi.
System backupowy może raportować wysoką skuteczność zadań, lecz taki wynik zazwyczaj potwierdza tylko wykonanie zaplanowanej operacji: odczyt danych ze źródła, zapis w repozytorium i ewentualną kontrolę techniczną. Nie dowodzi, że wszystkie zależności aplikacji zostały objęte ochroną ani że odtworzone komponenty zadziałają razem.
Pomiędzy utworzeniem kopii a powrotem usługi do działania znajduje się cały łańcuch: wybór właściwego punktu w czasie, dostęp do repozytorium, odszyfrowanie danych, odtworzenie konfiguracji, uruchomienie aplikacji, połączenie z usługami zależnymi oraz walidacja funkcjonalna. Awaria jednego ogniwa może zatrzymać cały proces.
Przywrócenie pliku lub wolumenu potwierdza tylko określony fragment zdolności odzyskiwania. Dla właściciela procesu ważne jest, czy użytkownik może się zalogować, zarejestrować zamówienie, wystawić dokument, uruchomić produkcję albo obsłużyć klienta. Kryterium sukcesu powinno więc kończyć się na działaniu usługi lub uzgodnionej transakcji biznesowej.
Dodatkowe kopie mają sens, jeżeli ograniczają inne rodzaje ryzyka: awarię lokalizacji, przejęcie konta administracyjnego, usunięcie danych, błąd logiczny lub ransomware. Jeżeli wszystkie są tworzone tym samym mechanizmem, zarządzane z tych samych kont i przechowywane w jednej domenie zaufania, mogą jedynie powielać tę samą wadę.
Repozytorium może zawierać dane uszkodzone już w źródle, przerwany łańcuch kopii przyrostowych albo bazę bez wymaganych logów transakcyjnych. Kontrola sum kontrolnych pomaga wykrywać zmiany bitowe, lecz nie potwierdza sama z siebie poprawności logicznej aplikacji. Potrzebne są również mechanizmy właściwe dla danego systemu, na przykład sprawdzenie spójności bazy oraz uruchomienie funkcji aplikacyjnych.
W środowisku wielowarstwowym baza danych, pliki, usługi katalogowe, kolejki komunikatów i konfiguracja mogą być kopiowane w różnych momentach. Każdy backup może wyglądać poprawnie osobno, ale po połączeniu komponentów pojawią się braki lub rozbieżności. Test odtworzeniowy ujawnia, czy organizacja posiada spójny zestaw potrzebny do uruchomienia całej usługi.
Aktualizacje systemów, nowe zależności, zmiana certyfikatów, migracja platformy lub przebudowa sieci mogą sprawić, że dotychczasowa procedura przestanie działać. Dokument istniejący od lat nie jest dowodem gotowości. Ćwiczenie sprawdza go wobec aktualnej architektury, dostępnych kompetencji i rzeczywistych narzędzi.
Atakujący często próbują przejąć system backupowy, konta uprzywilejowane i dostępne repozytoria. Dlatego znaczenie mają separacja tożsamości, chroniona retencja, kopie offline lub logicznie izolowane oraz możliwość odtworzenia w odseparowanym środowisku. Test powinien uwzględniać scenariusz, w którym część podstawowych narzędzi administracyjnych jest niedostępna lub niezaufana.
Nie każdy test musi obejmować całe centrum danych. Zakres powinien wynikać z krytyczności usługi, profilu ryzyka, wymaganych parametrów odzyskania i zmian w środowisku. Ważne jest jednak, aby prostych testów nie przedstawiać jako dowodu pełnej gotowości.
Szybka próba potwierdza, że kopię można odnaleźć, odczytać i zapisać w lokalizacji docelowej. Jest przydatna do częstej kontroli podstawowej funkcji, ale nie weryfikuje zależności aplikacji ani czasu odbudowy usługi.
Odtwarzane są komponenty aplikacji, baza, konfiguracja i wymagane sekrety. Sprawdzenie obejmuje start usług, logi, integralność danych oraz wybrane funkcje. Na tym poziomie można wykryć brakujące zależności i niespójność punktów w czasie.
Disaster recovery (DR) oznacza zdolność przywrócenia systemów i operacji po poważnym zakłóceniu. Ćwiczenie DR łączy techniczne odtworzenie z decyzjami, komunikacją, priorytetami usług i akceptacją właścicieli procesów. To na tym poziomie organizacja sprawdza, czy odzyskuje działalność, a nie tylko infrastrukturę.
 Zakres testu powinien rosnąć wraz z krytycznością usługi i profilem ryzyka.
Dobry test ma zdefiniowany scenariusz, zakres i kryteria sukcesu. Nie powinien kończyć się komunikatem „restore completed”. Jego wynik musi pozwolić odpowiedzieć, czy odzyskany system jest kompletny, zaufany, dostępny dla właściwych użytkowników i gotowy do obsługi procesu biznesowego.
Odtworzenia wymagają nie tylko baz i plików. Potrzebne mogą być obrazy systemów, wersje aplikacji, konfiguracja infrastruktury, certyfikaty, klucze, licencje, konta awaryjne, reguły sieciowe oraz dokumentacja integracji. Test ujawnia elementy, których nie obejmuje obecna polityka backupu.
Zespół powinien zweryfikować, czy w sytuacji awaryjnej potrafi uzyskać dostęp do repozytorium, uruchomić konta typu break-glass i użyć wymaganych kluczy. Procedura zależna od podstawowej domeny tożsamości może zawieść właśnie wtedy, gdy domena jest niedostępna lub skompromitowana.
Walidacja techniczna obejmuje między innymi poprawny start usług, logi, spójność danych i komunikację między komponentami. Walidacja funkcjonalna sprawdza krytyczne operacje użytkownika. Oba poziomy są konieczne: aplikacja może działać technicznie, a jednocześnie zwracać błędne wyniki lub nie obsługiwać najważniejszej ścieżki biznesowej.
Po cyberataku najnowsza kopia nie musi być najlepsza. Może zawierać złośliwy kod lub zmiany wprowadzone przed wykryciem incydentu. Wybór punktu odtworzenia powinien łączyć historię kopii, oś czasu zdarzeń, analizę bezpieczeństwa oraz ocenę dopuszczalnej utraty danych.
 Udane przywrócenie danych to dopiero początek walidacji całej usługi.
RTO (Recovery Time Objective) to docelowy czas przywrócenia usługi. RPO (Recovery Point Objective) określa dopuszczalną utratę danych wyrażoną czasem, czyli jak daleko wstecz organizacja może się cofnąć. Wartości wpisane do planu są założeniami. Dopiero test pokazuje, czy można je osiągnąć.
Pomiar powinien obejmować cały okres od rozpoczęcia procedury do potwierdzenia działania usługi. W praktyce czas zajmuje nie tylko transfer danych, ale również podjęcie decyzji, uzyskanie dostępu, przygotowanie środowiska, uruchomienie zależności, walidacja oraz akceptacja biznesowa. Raportowanie wyłącznie czasu kopiowania z repozytorium zaniża rzeczywisty RTO.
Jeżeli ostatnia kopia jest niespójna lub potencjalnie skompromitowana, trzeba wybrać starszy punkt. Różnica między planowanym RPO a punktem faktycznie uznanym za bezpieczny wpływa na liczbę utraconych lub wymagających uzgodnienia transakcji. Ten skutek powinien być rozumiany przez właściciela procesu, nie tylko przez administratora.
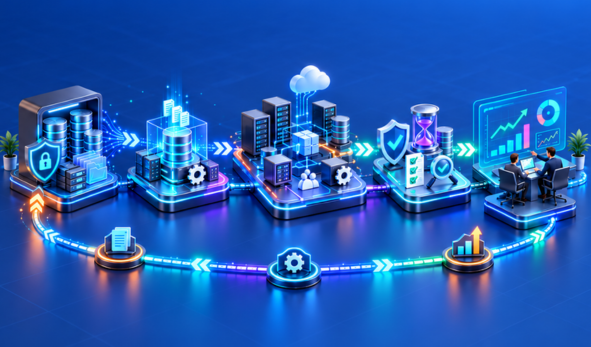
Test warto prowadzić jako kontrolowane ćwiczenie z wyznaczonym właścicielem, zakresem i kryteriami zakończenia. Poniższy model opisuje logikę procesu, ale nie zastępuje projektu dopasowanego do konkretnej infrastruktury.
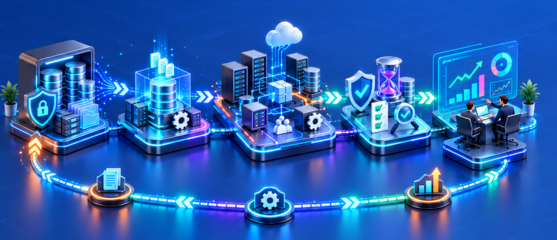
 Test prowadzi od scenariusza przez odtworzenie i walidację do raportu
oraz działań naprawczych.
Administratorzy odpowiadają za mechanizmy kopii, repozytoria i wykonanie odtworzenia. Architekci pomagają ustalić zależności oraz kolejność odbudowy. Zespół bezpieczeństwa ocenia zaufanie do punktu odzyskania, dostęp i izolację. Właściciele biznesowi definiują krytyczne funkcje oraz akceptują wynik.
Regularne testy odtworzeniowe są również istotnym elementem zarządzania ciągłością działania i cyberodpornością organizacji >>. Pozwalają nie tylko zweryfikować gotowość techniczną, ale także dostarczyć dowodów, że kluczowe usługi mogą zostać przywrócone zgodnie z przyjętymi wymaganiami bezpieczeństwa i odporności operacyjnej >>.
Techniczny zespół nie zawsze wie, które dane i transakcje mają największe znaczenie operacyjne. Dlatego biznes powinien wskazać minimalny zakres działania, dopuszczalne obejścia i kolejność przywracania. Test zakończony bez tej akceptacji może potwierdzić działanie infrastruktury, ale nie gotowość organizacji.
Raport nie może być jedynie archiwum logów. Powinien pokazywać osiągnięty RTO i RPO, niewykonane kryteria, zależności wymagające poprawy, prace manualne, ryzyko oraz właścicieli działań naprawczych. Dzięki temu wynik testu staje się narzędziem zarządzania odpornością.
Automatyczne odtwarzanie próbek, kontrola integralności, tworzenie izolowanego środowiska i uruchamianie testów technicznych zwiększają powtarzalność. Pozwalają szybciej wykryć, że zmiana aplikacji, konfiguracji lub uprawnień przerwała proces odzyskiwania.
Nie wszystko powinno jednak odbywać się bez udziału człowieka. Wybór bezpiecznego punktu po incydencie, ocena wpływu utraty danych, akceptacja procesu biznesowego i decyzja o powrocie do produkcji wymagają odpowiedzialności oraz kontekstu. Automatyzacja powinna dostarczać dowody i skracać pracę, a nie ukrywać założenia.
Infrastruktura jako kod (IaC) oznacza zarządzanie konfiguracją środowiska w kontrolowanych, wersjonowanych plikach. Podobne podejście można zastosować do odtwarzania: definiować środowisko testowe, kolejność operacji i kontrole techniczne w sposób powtarzalny. Zmiana systemu może wtedy uruchamiać odpowiedni test, zanim niezgodność zostanie odkryta podczas awarii.
Organizacja regularnie wykonuje kopie bazy ERP i maszyn aplikacyjnych. Podczas testu okazuje się, że baza została poprawnie przywrócona, ale konto usługi wygasło, certyfikat integracji z magazynem jest nieaktualny, a dokumentacja nie uwzględnia nowej kolejki komunikatów. Zadania backupowe były poprawne, lecz proces biznesowy nie mógł ruszyć.
Po analizie firma rozszerza zakres ochrony o konfiguracje i wymagane artefakty, aktualizuje mapę zależności oraz dodaje transakcje magazynowe i finansowe do kryteriów akceptacji. Wartością testu nie jest samo znalezienie błędów, lecz przekształcenie ich w mierzalne usprawnienia.
Usługa wykorzystuje lokalną bazę, zasoby chmurowe, zewnętrznego operatora tożsamości i potok wdrożeniowy. Test przywrócenia plików nie obejmuje całego łańcucha. Pełniejsze ćwiczenie ujawnia zależność od repozytorium kodu i sekretów zarządzanych z tej samej płaszczyzny administracyjnej.
Organizacja projektuje odseparowaną przestrzeń testową, przechowuje zatwierdzone artefakty oraz sprawdza logowanie, zapis danych i komunikację z usługami zależnymi. Scenariusz pokazuje, że nowoczesne odzyskiwanie dotyczy całej usługi, a nie wyłącznie wolumenu danych.
Wskaźniki powinny pokazywać jakość i powtarzalność procesu. Sama liczba kopii lub pojemność repozytorium nie mówi, czy organizacja osiąga cele ciągłości działania.
 KPI powinny mierzyć osiągnięty rezultat odzyskania, a nie wyłącznie
wykonanie backupu.
Testy wymagają zasobów obliczeniowych, czasu zespołu, izolowanej przestrzeni i udziału właścicieli procesów. Koszt rośnie wraz z zakresem oraz częstotliwością. Nie oznacza to jednak, że każdą usługę trzeba za każdym razem odtwarzać w pełnej skali.
Racjonalny model łączy częste automatyczne kontrole z rzadszymi testami aplikacyjnymi i pełnymi ćwiczeniami najważniejszych procesów. Budżet warto porównywać nie z samym kosztem przechowywania kopii, lecz z kosztem nieudanego odzyskania: dłuższym przestojem, pracą ręczną, utratą transakcji i decyzjami podejmowanymi bez wiarygodnych danych.
Organizacje zwykle rozwijają zdolność odzyskiwania etapami. Pierwszy poziom to monitoring wykonania backupu. Drugi dodaje automatyczną kontrolę integralności i próbki odtworzeń. Trzeci obejmuje aplikacje oraz pełne środowiska w izolowanej przestrzeni. Czwarty łączy regularne ćwiczenia DR, walidację biznesową, automatyzację i ciągłe doskonalenie.
Wysoki poziom dojrzałości nie oznacza maksymalnej liczby narzędzi. Oznacza, że organizacja zna zależności, mierzy wyniki, usuwa wykryte luki i potrafi przedstawić dowód odzyskania kluczowych usług.
 Dojrzałość rośnie od monitorowania zadań do regularnych ćwiczeń DR
i ciągłego doskonalenia.
Wiele kopii może zwiększać odporność, jeśli każda z nich ma jasno określoną rolę i ogranicza inny rodzaj ryzyka. Sama liczba kopii nie potwierdza jednak, że dane są kompletne, zależności znane, dostęp możliwy, a usługa rzeczywiście uruchomi się w wymaganym czasie.
Testy odtworzeniowe zamieniają założenia w dowody. Pokazują rzeczywisty RTO i RPO, ujawniają braki w konfiguracji, pozwalają zweryfikować procedury i kompetencje zespołu oraz dają właścicielom procesów podstawę do oceny ryzyka. Najdojrzalsze organizacje nie pytają więc wyłącznie: „ile mamy kopii?”, ale przede wszystkim: „kiedy ostatnio udowodniliśmy, że potrafimy z nich odbudować działającą usługę?”.
Częstotliwość powinna zależeć od krytyczności systemu, wymaganego RTO i RPO, zmian w środowisku oraz ryzyka biznesowego. Krytyczne systemy warto testować częściej niż systemy o niewielkim wpływie na działalność firmy.
Nie. Status zakończonego backupu potwierdza wykonanie operacji kopiowania, ale nie gwarantuje kompletności danych, poprawności konfiguracji ani możliwości uruchomienia całej usługi.
W zależności od zakresu może obejmować dane, aplikacje, konfigurację, konta, certyfikaty, sieć, integracje oraz walidację funkcjonalną z udziałem właściciela procesu biznesowego.
Backup służy do tworzenia kopii danych, natomiast Disaster Recovery obejmuje cały proces przywrócenia działania systemów i procesów biznesowych po poważnym zakłóceniu.
RTO określa maksymalny oczekiwany czas przywrócenia usługi, a RPO dopuszczalną utratę danych wyrażoną czasem. Test pozwala sprawdzić, czy wartości te są rzeczywiście osiągalne.
Tak. Pozwalają sprawdzić m.in., czy dostępny jest bezpieczny punkt odzyskania, czy kopie są odseparowane od zaatakowanego środowiska i czy organizacja może uruchomić system bez wykorzystania skompromitowanych zasobów.
Poprawnie wykonany backup nie daje jeszcze pewności, że po awarii, ransomware lub błędzie administracyjnym uda się przywrócić działającą usługę w czasie wymaganym przez biznes.
Monolit IT może zweryfikować proces backupu i odtwarzania, sprawdzić założone RTO i RPO oraz zmierzyć rzeczywisty czas i punkt odzyskania, wskazać brakujące zależności i luki w procedurach, a także zaprojektować testy odtworzeniowe dopasowane do krytyczności systemów i wymagań biznesowych.
Sprawdź, czy Twoje kopie zapasowe są nie tylko wykonywane, ale rzeczywiście gotowe do użycia w sytuacji awarii. Skontaktuj się z Monolit IT i porozmawiajmy o audycie backupu oraz testach odtworzeniowych w Twojej organizacji.